ARTICLE / ai
shell 输出三分之一是空格:填充 bug 该不该修
11 月 15 日,一位 Windows 用户在 Qwen Code 仓库贴了一份很少见的报告。他把本地约 600 份会话记录(约 2.6 GB)翻出来,统计 run_shell_command 输出里尾随空格占的比例:0.24.0 是 37%,0.24.6 是 33%,0.25.x 是 30–36%,0.27.0–0.27.2 是 26–35%;0.23.4 及更早只有 0.1%。
一条命令的输出,三分之一是空格。这些空格没有出现在程序自己的输出里,是捕获环节补上去的。
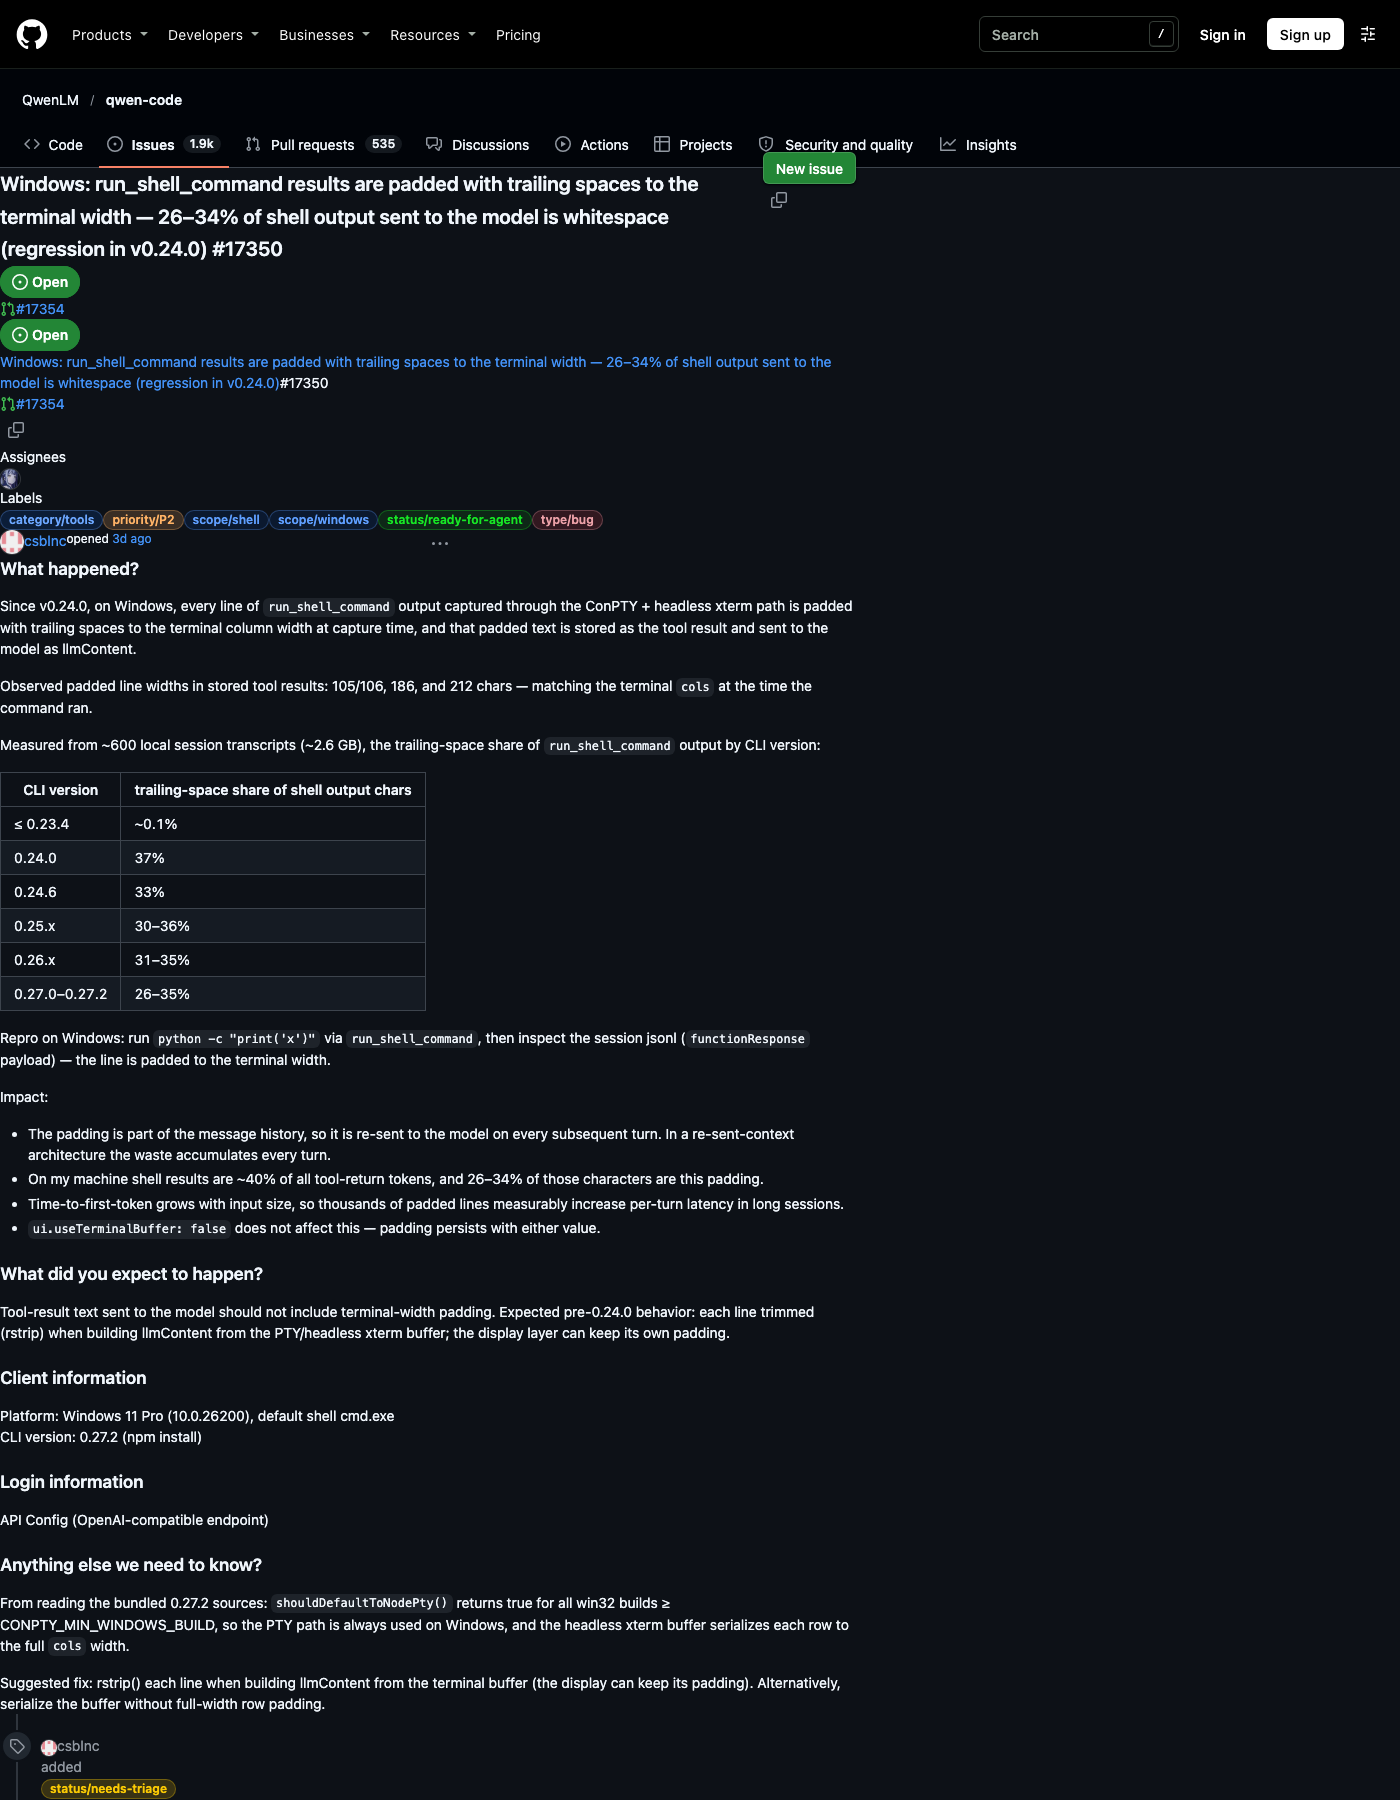 来源:GitHub QwenLM/qwen-code issue #17350 页面,github.com,截取日期 2026-11-18
空格是怎么进去的
按报告者的描述,Windows 上 run_shell_command 的结果走的是 ConPTY 加 headless xterm 的路径:命令输出先进入一个模拟终端,再从这个终端的缓冲区序列化成文本交给模型。
模拟终端的缓冲区是按网格存的,每一行有固定的列数 cols。序列化时把一行读出来,宽度不够就用空格补满——这是给屏幕渲染用的,补满才能对齐。
问题在于这份补满的文本同时被当成工具结果存了下来,并作为 llmContent 送进了模型。报告者观察到的填充后行宽是 105/106、186、212 字符,与命令执行时的终端列宽匹配。
为什么三分之一不算小事
单个空格不值钱,麻烦在于它会跟着对话一起被反复送出去。
agent 类工具的历史是一轮一轮重发的:这一轮补进去的填充,下一轮还在上下文里。按报告者的估算,shell 结果约占他全部工具返回的 40%(这一项他按 token 计),其中 26–34% 的字符是这种填充。填充会进入消息历史。报告者把三点影响写在一起:填充随历史重发而累积、在重发式上下文架构里会持续占用输入、首 token 延迟随输入体积增长。这三点他都按条件句写——来源没有说明 Qwen Code 是否采用重发式上下文,也没有单独测量填充对延迟的贡献。
还有一个让问题显得隐蔽的细节:ui.useTerminalBuffer: false 并不能绕开它,两个取值下填充都在。
根因是只删了一次末尾空白
Qwen 的 triage 机器人给了一段很干净的定位。它在 Linux 上静态读了 main 分支 cdb6610(v0.27.3)的源码,明确写了这批结论没有经过执行验证——受影响路径只在 Windows/ConPTY 上,而它跑在 Linux 上。
定位结论是:序列化函数 serializeTerminalToText 逐行调用 line.translateToString(true),再把折行拼起来,然后对整个拼接后的字符串做一次 trimEnd()。整个字符串只删一次末尾,中间那些行的填充原样留着。
而 translateToString(true) 按 getTrimmedLength() 截断,它跳过的只是尾部"从没被写入过"的单元格。一个存了真实空格字符(code 32)的单元格不算空,会被保留。所以屏幕上为了对齐补的空格,在文本层面是真实内容。
这条链路后面没有任何规整:result.output 被原样拼进 llmContent 里,格式是 Output: ${result.output || '(empty)'}。现有测试也没覆盖"已写入空格"的尾随单元格,terminalSerializer.test.ts 只测了软折行展开。一个长期没被发现的 bug,往往就卡在这种测试空档上。
修起来不难,难在别把真数据删掉
triage 给的修法是单点修复:在 serializeTerminalToText 里按逻辑行删尾随空白,这样前台结果、编码重放结果、后台提升快照三个调用方一次覆盖,展示层保持填充不动。
第二天,另一位参与者在评论区指出这个修法有个前提站不住:在折行展开之前按物理行裁剪,和在展开之后按逻辑行裁剪,并不等价。
他给的反例很短。两行 buffer,第一行是 abc 后面跟两个真实空格,第二行 def 标记为 wrapped,属于同一逻辑行的续行。如果先对每行 trimEnd 再拼接,得到 abcdef;不裁剪直接拼接,得到 abc def。前者把用户数据里的两个空格吃掉了。
终端可以恰好在字面空格处折行。所以填充和真实内容在视觉行这一层是分不开的,只有在拼回逻辑行之后才有机会区分。
删空白本身也是有损的
同一条评论还提了一个更根本的问题:对完成的逻辑行做 rstrip,也是一种有损归一。
命令行输出里字面尾随空格可能是有效信息——Markdown 两个空格表示硬换行,定宽数据靠空格对齐。模型拿到的文本一旦被裁剪,这些信息就补不回来了。而从 xterm 渲染出来的屏幕,本身也无法还原"这个空格是数据还是为了填满屏幕"。
能写清楚的只有产品契约:如果承诺的是"为上下文优化的人类可读终端文本",那就要把这条损失记录下来;如果承诺忠实于 stdout 字节,就需要另外保留一份原始捕获。屏幕/对象渲染器不该跟着改。
这是我在整条讨论里最认同的一点。同一个 bug,换个说法就是一处设计权衡:省下来的 token 从哪里来,代价是谁的信息。
版本归因也有出入
报告把回归起点定在 v0.24.0。triage 认为这个归因存疑:Windows shell PTY 改用内置 ConPTY 的 PR #11497 是在 v0.23.3 发布的,v0.24.0 的 release notes 里没有任何与命令输出或终端缓冲相关的改动。
它给出的解释是行为可能早于 0.24.0,或者报告者 ≤ 0.23.4 那一档样本太少没体现出来,并建议统计 0.23.3/0.23.4 的命令输出条数来确认。这个出入不影响修复方向,但影响读者判断自己的版本受不受影响:按 v0.27.3 的源码,win32 且 build ≥ 19042 时该判断函数返回 true、走 PTY 路径;早于 0.24.0 的版本是否同样填充,还得等 0.23.3/0.23.4 的样本统计。
如果你自己也在写 agent 工具
这类 bug 的通用形态是:把给人看的东西直接给了模型。
屏幕、终端、表格、进度条,这些渲染结果都有为对齐而生的填充字符。把它们当作模型输入之前,需要过一道明确的清洗,并且清楚清洗会损失什么。
自查的方法不复杂。找一个 CLI agent 的会话记录,看工具返回的内容里有没有成片的行尾空格,行宽有没有整齐地对齐到某个终端列宽(常见是 80、100、120、186、212 这类值)。整齐到可疑的程度,值得优先检查是不是渲染层的填充混进了模型输入。
另一种自查是量一次占比:把一次会话里所有 shell 结果拼起来,算其中填充字符的比例。报告者用的就是这条路,在 600 份记录上得到 26–34%。这里要区分两个口径——这个数说的是填充占 shell 结果字符的比例;他另处提到的「shell 结果约占全部工具返回 40%」按 token 计,两者不能混算。
判断
这个 bug 修不修,取决于你把省下的 token 当作什么。当成成本,它值得修:三分之一的白送字符,每一轮都在重发。当成信息完整性,它需要更小心:裁剪会带走真实数据空格。要裁剪,可以考虑放在逻辑行拼接完成之后;如果需要字节级保真,可以另存一份原始捕获。
仓库里已经有 PR #17354(fix(core): strip trailing spaces from each line of shell PTY output)在处理这条,截至 11 月 18 日,issue 页面顶部显示该 PR 状态为 Open。至于采用哪种裁剪粒度、要不要同时保留原始捕获,讨论里还没有定论——这也是我建议在代码注释里把契约定下来的原因:否则下一个人修同一处时,会再走一遍同样的权衡。